 Editions ENI Livres | Vidéos | e-Formations

Du client au serveur
Introduction
Le chapitre suivant explique ce qu’est HTTP, protocole au cœur d’Internet, des services web et de la relation client/serveur. HTTP signifie Hypertext Transfer Protocol. Il s’agit d’un protocole de communication client-serveur développé pour le Web et servant à transmettre des données hypermédias, telles que des pages web (fichiers HTML, HyperText Markup Language), des images, ainsi que des données audio et vidéo.
Dans ce chapitre, nous verrons d’abord ce qu’est le Web, puis nous aborderons la notion de client/serveur. Nous suivrons ensuite le chemin emprunté par une requête jusqu’à sa destination, avant d’expliquer la résolution des noms de domaine. Nous détaillerons enfin la structure d’une requête et d’une réponse HTTP, puis nous observerons concrètement une communication HTTP à l’aide d’un navigateur web.
Le Web
Autrement appelé WWW (World Wide Web), le Web est un service d’Internet qui permet de transmettre des informations à des clients au moyen de pages de sites hébergées sur des serveurs. On parle communément de navigation web, ou de surf sur Internet. Il s’agit aujourd’hui de l’une des principales sources d’information au monde, utilisée par des milliards de personnes.
À ne pas confondre avec Internet, qui représente l’ensemble du réseau de machines, constitué concrètement d’une multitude de réseaux interconnectés. Internet fournit l’infrastructure qui permet à des services comme le Web, via le protocole HTTP, de fonctionner. Il assure également le fonctionnement d’autres services, tels que l’envoi d’e-mails via les protocoles IMAP (Internet Message Access Protocol) ou SMTP (Simple Mail Transfer Protocol), ainsi que le transfert de fichiers via le protocole FTP (File Transfer Protocol). Ces services fonctionnent indépendamment les uns des autres.
Un peu d’histoire
Nous vous proposons cette brève chronologie pour vous situer :
-
1969 : Arpanet est présenté au grand public (ancêtre d’Internet). Au départ, il permettait de connecter deux réseaux universitaires américains.
-
1971 : Arpanet connecte 15 réseaux différents.
-
1973 : Arpanet connecte la Norvège et l’Angleterre.
-
1974 : première référence à Internet dans la réflexion sur le développement de ce que l’on connaîtra plus tard sous le nom de TCP/IP (Transmission Control Protocol/Internet Protocol).
-
1982 : standardisation de la suite de protocoles TCP/IP.
-
1986 : la National Science Foundation Network (NSFNet) fournit à des chercheurs américains un accès à des réseaux hébergeant des supercalculateurs (premier débit à 56 kbit/s).
-
1988/1989 : le NSFNet s’étend dans le monde : c’est le début d’Internet en tant que réseau mondial. Il interconnecte différents continents via des réseaux universitaires.
-
1989 : premiers FAI (fournisseurs d’accès à Internet) commerciaux aux États-Unis et en Australie.
-
1990 : première liaison haut débit (1,5 Mbit/s) entre les États-Unis et l’Europe. WorldWideWeb et CERN httpd sont respectivement le premier client web et le premier serveur web....
Clients/serveurs
Quel que soit le réseau utilisé, en local ou sur Internet, on retrouve la notion de clients et de serveurs.
Les clients désignent les logiciels installés sur les ordinateurs ou smartphones des utilisateurs et qui permettent d’interagir avec un serveur web, plus précisément pour afficher, créer, modifier ou supprimer du contenu en effectuant des requêtes HTTP. On pense le plus souvent aux navigateurs web (Firefox, Chromium, etc.), mais aussi à la majorité des applications mobiles ou encore à certains outils en ligne de commande (curl, wget, etc.).
Les serveurs web désignent les ordinateurs qui hébergent des sites et des applications web, puis les exposent sur un réseau via un service web (Apache, Nginx, etc.). Ils émettent des réponses aux requêtes HTTP des clients.
Pour illustrer ce fonctionnement, voici ce qui se passe lorsque l’on demande l’affichage de la page d’index d’un site web hébergé sur un serveur situé quelque part sur Internet. La communication se déroule en plusieurs étapes :
1. Le client, connecté à Internet via une interface réseau, par l’intermédiaire de son routeur, grâce à un câble Ethernet ou sans fil, résout le nom du site pour déterminer son adresse IP.
2. Une fois l’adresse...
Chemin d’une requête
Dans la section précédente, nous avons vu que la requête HTTP sortait du réseau du client via son routeur. Ce n’est pas le cas lorsque le serveur est situé sur le même réseau que le client, par exemple dans un réseau local d’entreprise : dans ce cas, la communication ne sort pas du réseau.
Il est d’ailleurs possible de voir concrètement tout le chemin qu’emprunte une requête avant d’atteindre sa destination avec des outils en ligne de commande tels que traceroute ou tracepath (tracert sous Windows). On l’utilise comme ceci :
traceroute <site> traceroute mettra en évidence les « sauts » que devra faire un paquet, une requête, pour atteindre sa destination, seul le franchissement d’un routeur est considéré comme un saut. L’affichage d’étoiles (wildcards) ou encore du message « no reply » indique que le paquet n’arrive pas à être reconnu dans un certain délai (timeout) par le prochain routeur.
Exemple 1 : chemin emprunté pour atteindre google.com
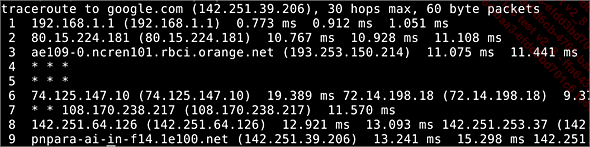
Une résolution du nom de domaine en adresse IP est effectuée dès le début. Le client recherche ainsi l’adresse IP du site demandé (142.251.39.206) en passant par son routeur Internet, situé à...
Résolution de nom
Vous vous êtes peut-être demandé comment notre navigateur et l’outil traceroute ont trouvé l’adresse IP de Google et celle du site hébergé en local dans les exemples donnés.
C’est grâce au DNS (Domain Name System), un service informatique installé sur des serveurs, qui permet d’associer les noms de domaine Internet ou locaux à leur adresse IP respective. On peut le comparer à un annuaire téléphonique qui associe des numéros de téléphone à des personnes ou à des adresses.
Concrètement, sans DNS, il serait impossible pour un être humain de naviguer simplement sur Internet. Par exemple, avez-vous retenu l’adresse IP de google.com ?
En revanche, sur un petit réseau local avec un site web hébergé, on pourrait raisonnablement se passer de nom de domaine.
1. Fonctionnement
Le fichier hosts est consulté par l’ordinateur du client avant l’accès au site web demandé. Si une adresse IP est associée à un nom de domaine dans ce fichier, l’ordinateur la retient ; sinon, il interroge les serveurs DNS configurés dans l’interface réseau active. Si le site est associé à une adresse IP, le client tente d’établir la connexion ; dans le cas contraire, il n’y parvient...
Messages HTTP
Les messages désignent le mécanisme d’échange entre un client et un serveur, c’est-à-dire la requête et la réponse.
Requête
La requête est générée par le client qui veut communiquer avec un serveur web.
Elle contient :
-
une URL (Uniform Resource Locator) cible : elle correspond à l’adresse IP ou au nom du serveur, le plus souvent à un nom de domaine, éventuellement suivi d’un chemin vers la ressource avec laquelle on veut interagir ; à défaut, ce chemin est l’index (/) du site ;
-
une méthode HTTP : elle indique au serveur l’action attendue pour la requête ;
-
un certain nombre d’en-têtes (headers), dont éventuellement des cookies.
Réponse
La réponse est générée par le serveur qui reçoit la requête HTTP.
Elle contient :
-
des en-têtes, dont éventuellement des cookies ;
-
un code de retour HTTP ;
-
du contenu comme une page web, une image, etc.
1. Méthodes HTTP courantes
On dispose de différentes méthodes pour envoyer une requête HTTP à un serveur, selon l’action attendue.
a. GET
Cette méthode permet de demander une ressource à un serveur en passant par l’URL.
Exemple : je saisis l’adresse https://www.editions-eni.fr/ dans la barre d’adresse de mon navigateur Internet afin d’afficher la page web correspondante.
Il est également possible que le client transmette des données via GET, par exemple au moyen d’un formulaire. Dans ce cas, les données saisies sont transmises via l’URL.
b. POST
Cette méthode permet à un client de transmettre des données au serveur, par exemple via un formulaire. Dans ce cas, c’est le formulaire qui précise si la requête doit utiliser la méthode POST.
2. Autres méthodes
Nous présentons ici brièvement les autres méthodes HTTP existantes, moins utilisées que GET et POST.
HEAD
Comme GET, HEAD permet de demander une ressource, mais la réponse ne contient pas de corps : elle inclut uniquement les en-têtes et le code HTTP.
OPTIONS
Retourne les méthodes HTTP prises en charge par le serveur web.
CONNECT
Utilisée pour établir une connexion vers un serveur...
HTTPS
Hypertext Transfer Protocol Secure, qui associe les protocoles HTTP et TLS (Transport Layer Security, remplaçant de SSL, Secure Socket Layer), également désigné par l’expression HTTPS over TLS, est devenu incontournable ces dernières années pour la sécurité des connexions entre clients et serveurs.
TLS permet de sécuriser une session HTTP en chiffrant la communication entre clients et serveurs pour garantir la confidentialité et l’intégrité des données. Il chiffre ainsi la requête et la réponse, avec leurs en-têtes respectifs.
Il permet aussi de s’assurer de l’identité des parties prenantes lors d’une session HTTP.
La communication se fait alors généralement via le port 443 du serveur.
Voir le chapitre Configuration du serveur - Les certificats TLS pour connaître les enjeux liés à HTTPS et apprendre à mettre en place un certificat TLS sur son serveur web.
Anatomie d’une session HTTP
Il est aisé d’observer une communication HTTP entre un client et un serveur en utilisant les outils de développement d’un navigateur Internet.
Dans l’exemple qui suit, nous utilisons le navigateur Brave. Ce navigateur est basé sur Chromium : ce qui est montré fonctionnera donc probablement aussi avec les autres navigateurs basés sur Chromium, comme Chrome. Le fonctionnement est sensiblement le même avec Firefox.
Ouvrez votre navigateur, accédez au site https://www.editions-eni.fr, appuyez sur [F12].
Ouvrez l’onglet Réseau ou Network, puis rechargez la page avec [F5].
On voit alors qu’un certain nombre de requêtes ont été exécutées (57). En effet, de façon transparente pour l’utilisateur, le client charge le contenu présent sur la page web HTML demandée en effectuant autant de requêtes HTTP qu’il y a de contenus à récupérer (images, fichiers CSS, etc.) afin de l’afficher correctement à l’utilisateur.
En remontant à la première requête effectuée pour charger le site, c’est-à-dire la requête initiale du client, on peut observer trois éléments dans les en-têtes, répartis dans trois sous-onglets :
-
Onglet General : indique que la requête est formée...